Geeft jouw Meta Business-account ongemerkt de sleutels van je website weg?
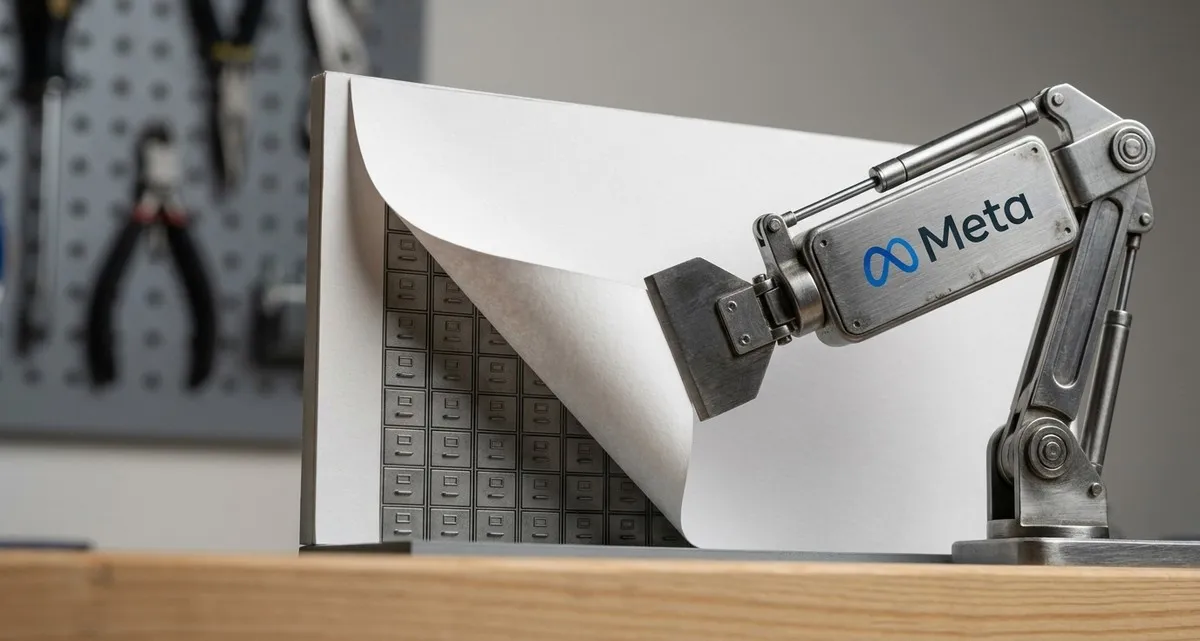
Afbeelding gemaakt met AI
Dit artikel en de omslagafbeelding zijn gemaakt met kunstmatige intelligentie (AI).
Gebruik je Facebook of Instagram om je bedrijf te promoten? Dan maak je waarschijnlijk gebruik van de Meta Business Suite. Het is een handig, gratis dashboard waarmee je berichten plant, berichten beheert en ziet hoe je advertenties presteren. Maar in de digitale wereld is ‘gratis’ zelden echt gratis; meestal betaal je met je data.
Recente rapporten en juridische experts wijzen op een belangrijke wijziging in de commerciële voorwaarden van Meta. Vanaf 30 oktober past het bedrijf de regels aan over hoe het toegang krijgt tot de websites die aan deze business-accounts zijn gekoppeld.
Kort gezegd: door een Meta Business-account te blijven gebruiken, geef je het bedrijf toestemming om geautomatiseerde tools te gebruiken om je website te ‘scrapen’ om zo hun AI-modellen te trainen.
Wat is web-scraping precies?
Voor een ondernemer klinkt ‘scraping’ misschien als iets dat met een schaafwond te maken heeft, maar in de tech-wereld is het een methode om data te verzamelen.
Web-scraping is het gebruik van geautomatiseerde software — vaak bots, crawlers of ‘spiders’ genoemd — die een website bezoeken en alles op de pagina ‘lezen’. In plaats van dat een mens door je site klikt om een prijslijst te vinden, kan een bot in enkele seconden duizenden pagina’s scannen en alle teksten, afbeeldingen en de structuur kopiëren naar een database.
Meta geeft nu expliciet aan dat ze deze bots kunnen gebruiken om de domeinen en URL’s die aan jouw bedrijfsproducten gekoppeld zijn, te indexeren en te analyseren. Deze data wordt vervolgens gebruikt om hun AI-diensten te “leveren, ontwikkelen, verbeteren, onderzoeken en trainen”.
Waarom dit belangrijk is voor jouw bedrijf
Voor velen voelt dit als een technisch detail, maar eigenlijk is het een overdracht van een digitaal bezit. Je website bevat jouw specifieke manier van ondernemen: je prijsstrategieën, je unieke servicebeschrijvingen en je zorgvuldig samengestelde content.
Stel je een tandartspraktijk voor die jarenlang gedetailleerde gidsen over patiëntenzorg heeft geschreven om nieuwe cliënten aan te trekken, of een bakker met een unieke, zorgvuldig geformuleerde beschrijving van zijn ambachtelijke proces. Wanneer Meta deze data scrapt, wordt die specialistische kennis geabsorbeerd in een AI-model. De AI ‘steelt’ je website niet in die zin dat je site verdwijnt, maar het gebruikt jouw intellectuele inspanning om eigen tools slimmer te maken. Als een potentiële klant een Meta AI-tool vraagt naar een specifieke tandheelkundige ingreep, kan de AI een antwoord geven gebaseerd op de exacte expertise die de praktijk heeft gepubliceerd, zonder dat de klant ooit de website van de praktijk hoeft te bezoeken.
De realiteit: geen opt-out
Het meest kritieke deel van deze update is dat je geen keuze hebt. Volgens juridische experts is er geen mogelijkheid om specifiek voor deze voorwaarde af te zien (een opt-out).
Als je de Meta Business Suite wilt blijven gebruiken om je Instagram- en Facebook-aanwezigheid te beheren, moet je deze voorwaarden accepteren. Als je het er niet mee eens bent, is het enige echte alternatief om volledig te stoppen met het gebruik van de zakelijke tools van het platform. Voor de meeste kleine ondernemers is dat geen optie, omdat ze daarmee hun belangrijkste manier verliezen om klanten te bereiken.
Dit onderstreept een terugkerende les in het moderne bedrijfsleven: Algemene Voorwaarden zijn geen juridische bijzaak. Het zijn de contracten die bepalen wie jouw data bezit en hoe deze gebruikt mag worden zodra het jouw server verlaat.
Hoe je jouw digitale aanwezigheid beschermt
Hoewel je niet kunt weigeren als je op het platform blijft, kun je nog steeds stappen ondernemen om te controleren hoe de rest van het internet — en andere AI-bots — met je website omgaat.
Een van de eerste verdedigingslinies is het robots.txt-bestand. Dit is een simpel tekstbestand op je server dat fungeert als een ‘verboden toegang’-bord voor bepaalde bots. Hoewel sommige agressieve scrapers dit negeren, volgen veel gerenommeerde bots deze instructies. Je kunt je site zo configureren dat specifieke AI-crawlers worden verteld dat ze je content niet mogen indexeren.
Daarnaast is beveiligingsmonitoring essentieel. Je moet weten wanneer je site een ongebruikelijke piek in verkeer ervaart door geautomatiseerde bots. Als een bot je site te agressief scrapt, kan dit de laadsnelheid van je pagina’s voor echte klanten vertragen, wat slecht is voor je positie in zoekmachines en de gebruikerservaring.
Veelgestelde vragen
Betekent dit dat Meta mijn privébestanden van mijn bedrijf kan inzien? Nee. Dit gaat specifiek over ‘web-scraping’, wat betekent dat de bots kijken naar de openbare delen van je website en de URL’s die je in je bedrijfsprofiel linkt. Ze hebben geen toegang tot je interne privédocumenten, tenzij die documenten openbaar op je website staan.
Verdwijnt mijn website hierdoor uit de zoekresultaten van Google? Nee. Dit is iets anders dan indexering door zoekmachines. Meta verzamelt data om AI te trainen, niet om de manier waarop Google je bedrijf vindt te vervangen. Het doel van AI is echter vaak om het antwoord direct aan de gebruiker te geven, waardoor er soms minder mensen daadwerkelijk op je website klikken.
Kan ik Meta tegenhouden om mijn site te scrapen, maar wel mijn Facebook-pagina behouden? Op basis van de nieuwe voorwaarden geldt dat als je de Meta Business Suite gebruikt (het dashboard voor het beheer van je bedrijf), je akkoord gaat met deze voorwaarden. Er is momenteel geen manier om de zakelijke tools te gebruiken en tegelijkertijd de scraping te weigeren.
Neem de controle over je data terug
Het is makkelijk om je machteloos te voelen wanneer een wereldwijd platform de regels verandert, maar je hoeft je digitale deuren niet wijd open te laten staan. Het doel is om de marketingvoordelen van sociale media in balans te brengen met de bescherming van de intellectuele eigendom van je bedrijf.
Bij IT Move NL helpen we ondernemers bij het implementeren van de technische beveiligingen die nodig zijn om data veilig te houden. Of het nu gaat om het optimaliseren van je robots.txt-instellingen of het opzetten van professionele monitoring om te zien wie je site bezoekt en waarom: wij zorgen dat jouw technologie voor jou werkt, en niet andersom.
Twijfel je waar je data mogelijk weglekt of wil je weten of je website goed beschermd is tegen agressieve AI-bots? Wij kunnen je helpen. Neem contact met ons op voor een uitgebreide security-audit om je kwetsbaarheden in kaart te brengen en de controle terug te krijgen via /contact.
Bronnen:
- Have a Meta business account? You’re consenting to AI scraping now, legal experts say
- Meta grants itself right to scrape content from business customers for model training
- Meta draait AI-model met 816 miljard parameters op twee Macs
- Twee Mac Studio’s met M5 Ultra kunnen Meta’s Muse Spark Open-model draaien

Gecontroleerd door
David Velarde RoblesHij/Hem · Inhoudelijk controleur · AWS Certified Solutions Architect | Cloud Engineer @ Essent
Cloud Engineer bij Essent B.V. met meer dan 10 jaar ervaring in de tech-industrie. AWS Certified met een passie voor serverless architecturen, Infrastructure as Code en DevOps. Bedreven in TypeScript, Python en Terraform. Gevestigd in Amersfoort.
BLIJF OP DE HOOGTE
// Cloud, AI & DevOps inzichten — direct in je inbox.
Geen spam. Uitschrijven wanneer je wilt.
// Gerelateerde artikelen
Hulp nodig met je cloud infrastructuur?
Ons team van experts staat klaar om je te helpen met de complexiteit van moderne cloud architectuur.
Neem Contact Op